Pythonが遅いのはなぜですか?
Pythonは高水準の動的言語であるため、コードは実行時にのみコンパイルされ、コンパイルプロセスには多くの複雑な処理が含まれます。例えば、Pythonの構文は変数宣言を大幅に簡素化しており、変数の型を指定する必要がありません。そのため、インタープリタは実行時に変数の型を推論する必要があり、これにはより多くの時間がかかります。
つまり、Pythonがコードを書くのをこれほど簡単にする理由は、裏で面倒な処理をすべて引き受けてくれるからだ。
低レベル言語を使う以外に、まず試せる方法はありますか?
forループを使用している際に、反復回数が非常に多い場合は、その処理を行列演算に置き換えることができるかどうかを検討し始めるべきです。
Python 初心者や線形代数を初めて学ぶ人は、行列に馴染みがないかもしれません。簡単に言うと、行列とは単に数値を正方行列に並べ、同じ方法で同時に処理するものです。これらの操作には、線形代数の範疇に属する複雑で入り組んだ手法が数多く含まれています。しかし、ここでは線形代数の知識は必要ありません。NumPy は、行列演算を素早く実装できる非常に強力な Python パッケージです。その高速性は、基盤となる C 言語で大幅な最適化が行われていること、そして最も重要なのは、マシンのパフォーマンスを最大限に活用して並列計算を実行できることに起因しています。これに対し、Python の for ループは逐次処理であり、次の計算を開始する前に前の計算が完了するまで待つ必要があります。大量のデータを扱う場合、この速度は致命的です。
もちろん、すべてのループロジックを行列演算で置き換えることはできません。たとえば、forループを使用して複数のAPIを要求する場合、このループロジックには数値計算以外の演算も含まれるため、行列演算で置き換えることはできません。しかし、この例のように、純粋に数値計算のみを実行するループを抽象化できる場合、APIがすべてのデータを一度に返すことができれば、そのデータを行列に書き込み、行列演算を使用してデータを並列処理することができます。
例:4次元データを3次元座標系で表示する
私はかつて四次元空間に非常に興味を持っていました。数学的に言えば、四次元空間は確かに存在します。しかし、四次元の物体を三次元空間に直接表示することはできないと知っています。そこで、少なくとも四次元空間の存在をよりよく理解できるよう、データを表現する方法を見つけようと考えました。その良い方法の一つが、三次元画像にグラデーションカラーを用いて四次元のデータを表現することです。
だから、あまり深く考えずに、たくさんのネストされたforループを使って、さっと書き上げた。
import pandas as pd

def oscillate_range(stop):
    """
    range但是以这种方式生成:
        0, -1, 1, -2, 2, -3, 3, ..., -stop/2, stop/2

    note:
        由于我们从四维正方体中通过判断半径长度来挖出一个四维球体,
        而利用这种方式生成可以从中心向正负两边出发,
        避免在四维正方体的几个角落进行多余的计算。
    """
    a, counter = 0, 0
    while True:
        if counter > stop:
            return
        yield a
        if a == 0:
            a -= 1
        elif a < 0:
            a = -a
        else:
            a = -a
            a -= 1
        counter += 1

def forloop_process():
    # 画图用的数据结构
    df4d = pd.DataFrame({'x': [],
                        'y': [],
                        'z': [],
                        'w': []})
        # 生成半径为10的实心球,r的值从0到10
        for r in range(11):
            # 圆心为(0, 0, 0)
            # 生成x坐标
            for x in oscillate_range(20):
                # 生成y坐标
                for y in oscillate_range(20):
                    # 判断是否在球内
                    if x ** 2 + y ** 2 > r ** 2:
                        continue
                    # 生成z坐标
                    for z in oscillate_range(20):
                        # 判断是否在球内
                        if x ** 2 + y ** 2 + z ** 2 > r ** 2:
                            continue
                        # 生成w坐标
                        for w in oscillate_range(20):
                            # 判断是否在球内
                            r_calculated_2 = x ** 2 + y ** 2 + z ** 2 + w ** 2
                            if not r_calculated_2 <= r ** 2: # 不在球内
                                break
                            else: # 在球内
                                data = {'x': x,
                                        'y': y,
                                        'z': z,
                                        'w': w}
                                # 将数据添加到画图用的数据表中
                                df4d = pd.concat([df4d, pd.DataFrame(data, index=[0])])
ご覧のとおり、この処理を最適化するために、不要なループ回数を減らす目的で、ジェネレーターoscillate_range作成しました。最外側のループの進行状況バーを表示するために、tqdmモジュールを使用しました。
for r in tqdm(range(11)):


ご覧のとおり、最初のループの速度は速くはありませんが、許容範囲内です。しかし、ループの終わりに近づくにつれて、速度が著しく低下します。これは、同じサンプリング精度の場合、半径が小さいほど球内のデータポイントが少なくなり、その逆もまた然りです。半径が大きいほど球内のデータポイントが多くなり、結果として計算時間が長くなります。振り返ってみると、最初にこのコードを実行したときは、球を作成しているだけで、トイレに行った後でもまだ完了していませんでした。Pythonのパフォーマンスが私の気分に本当に影響を与えたのはこれが初めてでした。そこで、もっと良い実装方法があるはずだと感じ、それが次の話につながりました。
def matrix_process():
    # 给每个维度创建一个一维长度矩阵
    X = np.arange(-10, 10)
    Y = np.arange(-10, 10)
    Z = np.arange(-10, 10)
    # 由于颜色没法在同一个数据点上显示多个值,所以改变球心在第四维的位置
    W = np.arange(0, 20)
    # 用numpy准备的非常贴心的meshgrid函数生成每个维度对应的四维网格矩阵
    # 这一步其实一开始是最难理解的,这相当于把每个一维长度向另外三个维度的方向平铺了一遍,因此能确保当x,y,z,w这四个四维矩阵按位置一一对应起来正好能组成所有的数据点的坐标。
    x, y, z, w = np.meshgrid(X, Y, Z, W)
    # 同时计算每个坐标点距离原点的距离,并行计算的好处开始体现出来了。
    r = np.sqrt((x - 0) ** 2 + (y - 0) ** 2 + (z - 0) ** 2 + (w - 10) ** 2)
    # 找出在球体内的数据点,并将其坐标储存到画图用的数据集
    r_idx = np.where(r <= 10)
    df4d = pd.DataFrame({'x': X[r_idx[0]],
                        'y': Y[r_idx[1]],
                        'z': Z[r_idx[2]],
                        'w': W[r_idx[3]]})
タイミング計測にはtimeitモジュールを使用してください。
print(timeit.timeit(stmt=matrix_process, number=1))
# out: 0.004268000018782914
ご覧のとおり、上記のネストされたforループで行っていた処理は、単一のmeshgrid関数のみを使用して実行されました。さらに、並列処理速度は数桁速く、計算順序を気にする必要がなくなりました。
要約する
マトリックス版のコードは一見シンプルに見えますが、meshgrid関数は内部で多くの処理を行っており、私たちが独自に記述するシンプルで直感的なネストされたループロジックよりもはるかに複雑です。
さらに、多くのPython初心者は、経験豊富なプログラマーがPythonの速度の遅さを嘆いているのを耳にし、コーディングを始める際に最適化や速度改善について不安を感じているのではないでしょうか。しかし、実際にその苦労を身をもって経験して初めて、解決策を見つける必要性を実感し、自然と適切な最適化戦略を見出すことができるのです。せっかくPythonを選んだのですから、コーディングの第一原則である「とにかく動かせるようにする」ことに集中しましょう。
忘れられた四次元球体
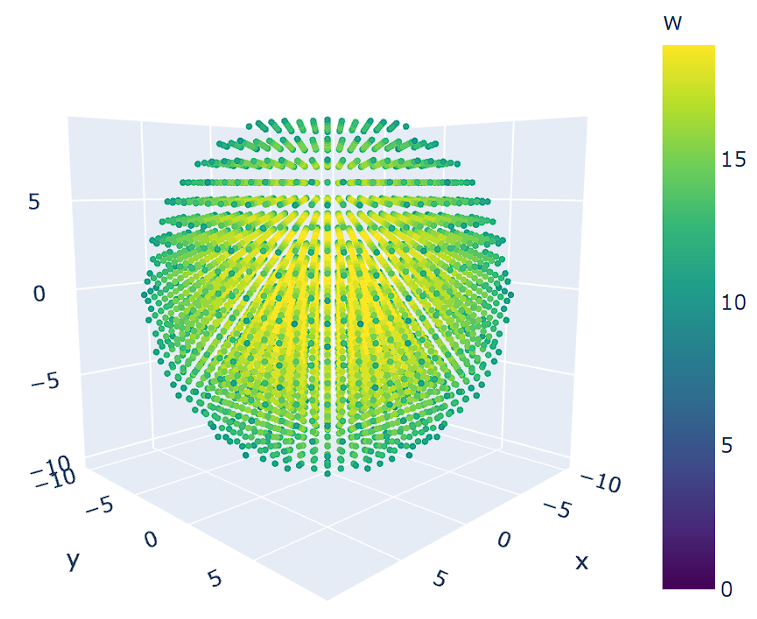
これは真の4次元球ではなく、4次元空間におけるデータ点の中心からの距離を色のグラデーションで表した3次元球です。言い換えれば、この3次元球は4次元球を3次元空間に投影したものです。図に示すように、中心に近づくほど4次元の値が大きくなります。したがって、4次元球が均一に3次元空間に圧縮され、その圧縮によって変形が生じないと仮定すると、球の密度は中心から増加すると考えるのが妥当です。最終的に変形が生じた場合、3次元的な観点から見ると、物質は中心から外側に膨張します。 『三体問題』のアナロジーを用いると、2次元の箔が3次元空間を2次元に落とし、結果として2次元空間が外側に広がるのと同様に、私たちの「3次元のレンガ」は4次元空間を3次元に落とし、この3次元空間をあらゆる方向に広げることができます。さらに、 『三体問題』が四次元空間を記述しているように、四次元的な視点から見ると、すべての構造は展開された状態で現れます。私たちの三次元球体モデルの内部では、四次元の物質の多くが、私たちの三次元空間において、まるで何もないところから突然出現し、球体の膨張を引き起こしているのです。
第一